《数据挖掘 第2版》书评 从特征分析到经典算法的系统指南
在数据科学领域,王朝霞教授所著的《数据挖掘 第2版》凭借其清晰的逻辑与扎实的内容,成为许多读者入门与进阶的重要参考。本书围绕数据挖掘的核心流程展开,尤其注重数据特征分析及预处理、经典数据挖掘算法等关键环节,形成了一套从理论到实践的知识体系。
一、数据特征分析及预处理:挖掘的基石
书中开篇即强调,现实世界的数据往往存在噪声、缺失、不一致等问题。王朝霞教授系统介绍了数据特征分析的方法,包括数据的统计描述、可视化以及相似性度量。数据预处理部分涵盖了数据清洗、集成、变换与规约等技术。这些内容不仅帮助读者理解数据的内在结构,也为后续建模打下坚实基础。例如,通过主成分分析(PCA)进行降维、利用分箱方法平滑噪声,都是书中详述的实用技巧。《数据挖掘 第2版》在此部分的讲解兼顾原理与操作,使读者能够快速上手真实数据集。
二、经典数据挖掘算法:从分类到聚类
作为教材的核心,本书对经典数据挖掘算法进行了全面梳理。分类算法方面,涵盖了决策树(如ID3、C4.5)、朴素贝叶斯、K近邻(KNN)、支持向量机(SVM)以及神经网络等;聚类算法则包括K-means、层次聚类、DBSCAN等。王朝霞教授不仅阐述了每种算法的数学推导与流程,还对比了它们的优缺点和适用场景。例如,在讲解决策树时,书中详细分析了信息增益、增益率与基尼指数的计算,并配有示例。关联规则挖掘中的Apriori算法与FP-growth算法同样得到深入剖析。这些经典算法是数据挖掘的根基,本书通过案例与习题帮助读者融会贯通。
三、数据挖掘:完整流程与实战视角
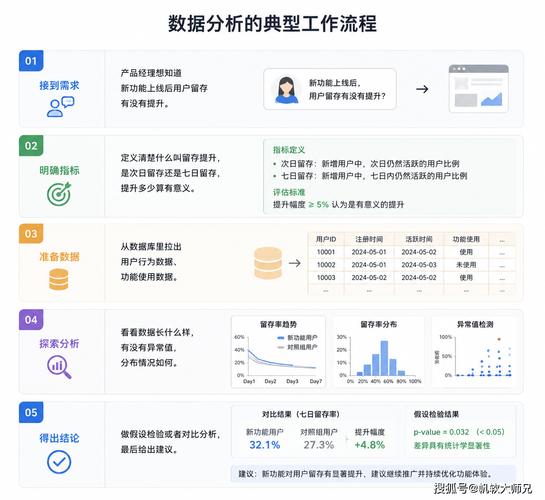
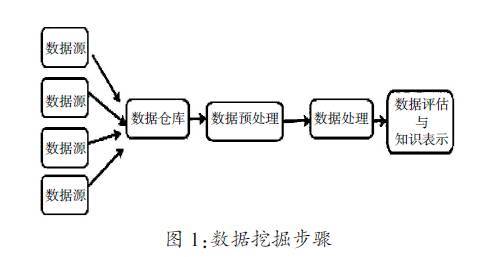
除了具体技术,本书还从系统角度介绍了数据挖掘的完整流程:问题定义、数据理解、数据准备、建模、评估与部署。这种CRISP-DM式的框架让读者跳出算法细节,把握整体项目逻辑。《数据挖掘 第2版》可能还涉及异常检测、时间序列分析等扩展内容,并强调模型评估指标(如准确率、召回率、ROC曲线)的重要性。王朝霞教授在书中融入了多年教学与科研经验,使得理论不枯燥,实践有方向。
《数据挖掘 第2版》以数据特征分析及预处理为起点,以经典数据挖掘算法为骨架,构建了一幅清晰的知识地图。无论你是计算机专业的学生,还是希望转行数据科学的从业者,本书都能帮助你扎实掌握数据挖掘的核心技能。王朝霞教授的这本著作,值得放在案头反复翻阅。
如若转载,请注明出处:http://www.chengka2018.com/product/46.html
更新时间:2026-10-15 03:39:36