利用Python爬虫爬取淘宝商品做数据挖掘分析实战篇超详细教程
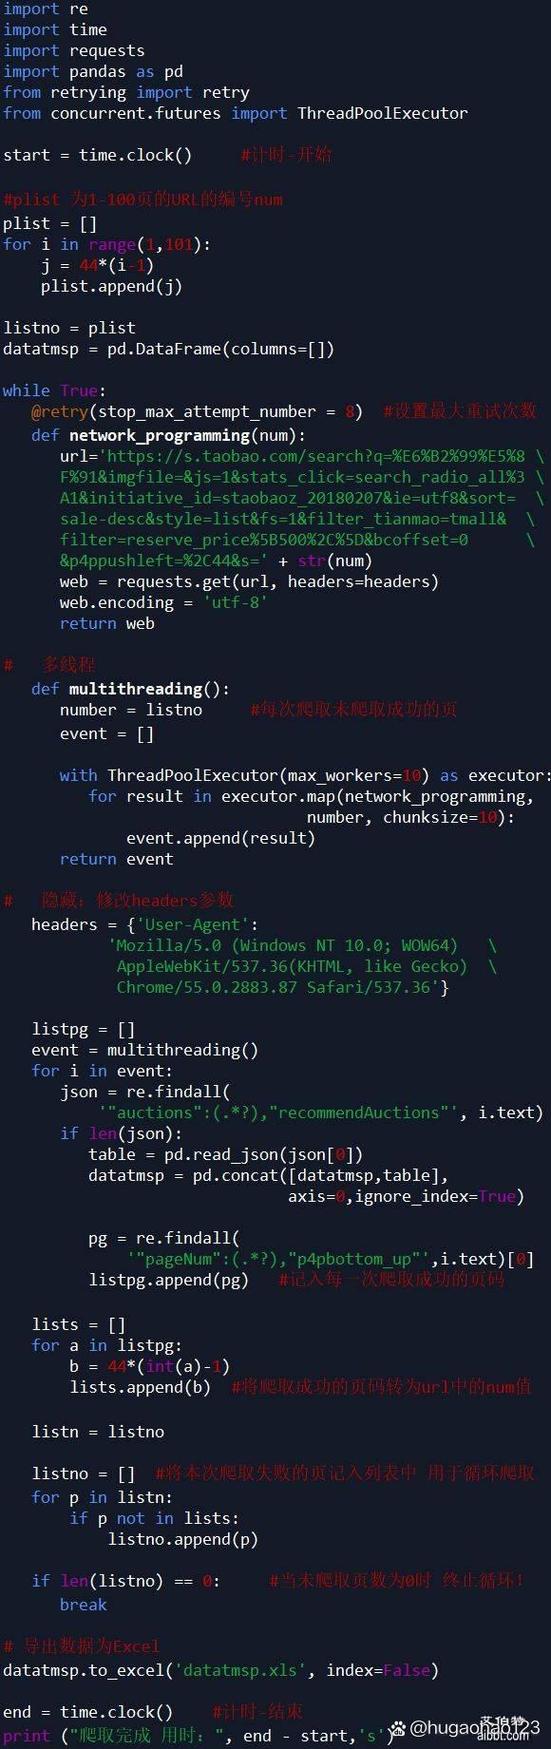
一、前言\n\n在电商竞争日益激烈的今天,获取商品数据并进行分析是每个运营和数据分析师的必备技能。本教程将手把手教你如何合规、高效地爬取淘宝商品数据,并进行数据挖掘分析,探索价格分布、销量趋势、用户评价等有价值的信息。请注意,本教程仅用于学习交流,请务必遵守淘宝robots协议及相关法律法规,避免对目标网站造成压力。\n\n目标:\n1. 掌握使用Selenium + BeautifulSoup/Requests爬取淘宝搜索结果页的方法(应对动态加载和登录限制)。\n2. 清洗与存储爬取到的商品数据(标题、价格、销量、店铺、地区等)。\n3. 利用Pandas、Matplotlib、WordCloud等库进行数据挖掘与可视化分析。\n\n## 二、环境准备\n\n### 2.1 安装必要库\n\n`bash\npip install selenium beautifulsoup4 requests pandas matplotlib jieba wordcloud openpyxl\n`\n\n### 2.2 下载ChromeDriver\n\n根据你的Chrome浏览器版本,下载对应版本的ChromeDriver,并放入系统PATH或指定路径。\n\n## 三、爬取淘宝商品数据\n\n### 3.1 分析页面加载方式\n\n淘宝搜索页面(如https://s.taobao.com/search?q=关键词)的商品数据是动态加载的。直接使用requests抓取会因为没有登录而跳转到登录页,且返回内容不全。因此我们采用Selenium模拟浏览器操作,并手动扫码登录(一次登录可长期保存Cookie)。\n\n### 3.2 完整爬虫代码示例\n\n`python\nimport time\nimport random\nimport csv\nfrom selenium import webdriver\nfrom selenium.webdriver.common.by import By\nfrom selenium.webdriver.support.ui import WebDriverWait\nfrom selenium.webdriver.support import expectedconditions as EC\nfrom bs4 import BeautifulSoup\n\n# 配置Chrome选项\noptions = webdriver.ChromeOptions()\noptions.addargument('--disable-blink-features=AutomationControlled')\noptions.addexperimentaloption('excludeSwitches', ['enable-automation'])\noptions.addexperimentaloption('useAutomationExtension', False)\noptions.addargument('user-agent=Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36')\n\ndriver = webdriver.Chrome(options=options)\ndriver.executecdp_cmd('Page.addScriptToEvaluateOnNewDocument', {\n 'source': 'Object.defineProperty(navigator, \
如若转载,请注明出处:http://www.chengka2018.com/product/51.html
更新时间:2026-10-15 10:26:39